Luật sư dựng server AI riêng bằng 8 GPU Nvidia V100 đã qua sử dụng
Lawyer builds private AI server with eight used Nvidia V100 GPUs
Tóm tắt nhanh
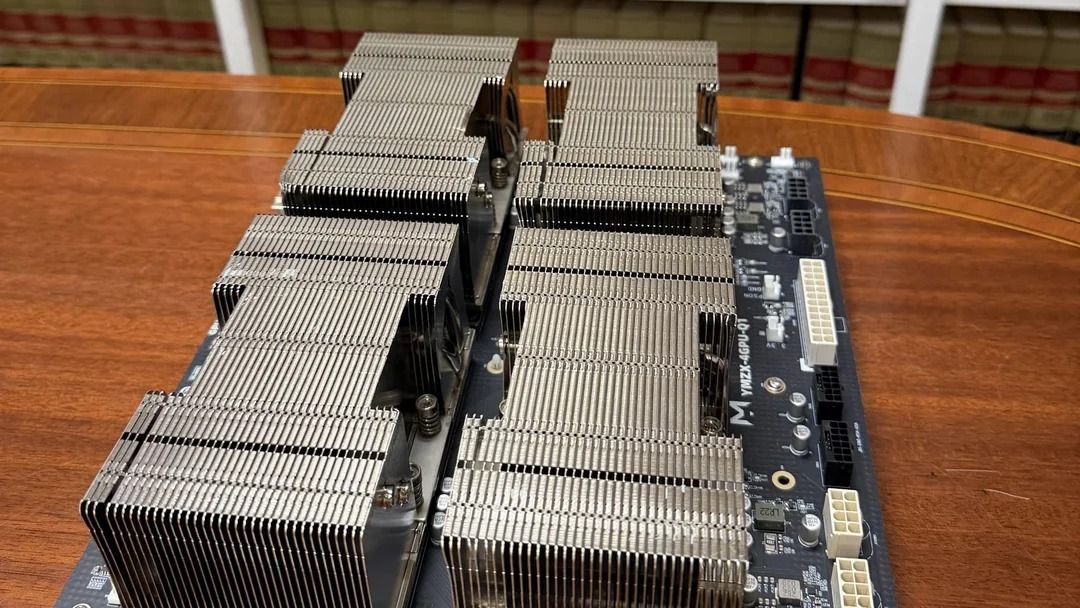
- Một luật sư đã tự dựng private AI server từ 8 GPU Nvidia Tesla V100 SXM2 32GB đã qua sử dụng để file vụ án không phải rời khỏi văn phòng. Hệ thống đang chạy DeepSeek V4.1 Flash và dùng để đọc hồ sơ, trích xuất факт, ngày tháng, số liệu, tóm tắt và soạn thảo sơ bộ.
- Máy dùng hai bo 4 GPU SXM2 NVLink, bốn card PEX switch và cáp SlimSAS, với một đầu nối nguồn từng bị cháy. Mỗi bo có 4 GPU nối NVLink với nhau, đạt 128GB VRAM/bo, còn hai bo chỉ giao tiếp qua PCIe.
- Các GPU V100-SXM2-32GB có 32GB HBM2 với băng thông 900 GB/s, cắm vào socket SXM2 thay vì khe PCIe. Builder cho biết hai bo được nối với host qua 2 PEX switch mỗi bo, tổng cộng 4 switch, mỗi switch phục vụ 2 GPU ở PCIe 3.0 x8.
- Khi mua, các bo 4 GPU có giá khoảng 2.400 USD/bo, còn builder nói mỗi card lúc đó khoảng 400 USD. Hiện card V100 SXM2 32GB trên eBay đã lên khoảng 900 USD/cái và các listing cho thấy giá vẫn đang tăng.
- Cấu hình đi kèm gồm mainboard Gigabyte Threadripper Pro, CPU 12 nhân 3945WX, 8 thanh 32GB DDR4 RDIMM, một NUMA node và 2 PSU tổng công suất 2.800 W. Hai PSU được cắm vào các mạch điện văn phòng riêng biệt.
- DeepSeek V4.1 Flash được nén chủ yếu xuống 2-bit, với tổng trọng lượng mô hình 248,8GB. Phần expert chạy hoàn toàn trong GPU memory, còn khoảng 110GB Engram tables nằm trong RAM hệ thống.
- Mô hình được chia làm hai nửa: layer 0–19 chạy trên bo SXM2 thứ nhất và layer 20–39 trên bo thứ hai. Mỗi bo xử lý lưu lượng nặng qua NVLink riêng, nên chỉ còn một lần chuyển qua PCIe giữa hai bo mỗi bước.
- Theo builder, hệ thống hiện dùng hàng ngày cho công việc hồ sơ và không có tài liệu nào rời khỏi máy nếu chưa được người thật xem lại. Ông cũng nói hệ thống hỗ trợ RAG databases, tool calls và điều khiển qua giao diện kiểu Discord qua SSH từ máy Windows.
- Về hiệu năng, server đạt tối đa 215 tokens/giây với code và 118 tokens/giây với legal writing. Mô hình nhận được tối đa 524K tokens context, còn ở 128K tokens thì token đầu tiên xuất hiện sau khoảng một phút.
Tóm tắt tự động bằng AI từ bài gốc, có thể có sai sót. Hãy kiểm chứng ở bài gốc.
Trích đoạn bài gốc
A lawyer runs DeepSeek V4.1 Flash on eight used 2018-era Nvidia V100 GPUs at up to 215 tokens/s, keeping case files in the office.Tapview chỉ hiển thị tiêu đề, trích đoạn ngắn, tóm tắt và đường dẫn tới bài gốc. Nội dung gốc thuộc bản quyền của Tom's Hardware.